AWS上のWebサーバー(httpd)で実現する、AI解析を活用した信頼性の高い自動リカバリ構成
Webアプリケーションの運用において、障害発生時のダウンタイム短縮と運用負荷の削減は重要な課題です。本記事では、AWS上のEC2(httpd)でプロセスが停止した際に、CloudWatch、Lambda、Amazon Bedrock(生成AI)、AWS Systems Manager(SSM)を連携させて安全に自動復旧するシステム構成を解説します。あわせて、この構成を一括でデプロイできるCloudFormationテンプレートも紹介します。
この記事の目次
全体構成と自動リカバリの仕組み
本構成では、単にプロセスが停止したら再起動するのではなく、安全確認(サーバーが高負荷に陥っていないか)とAI診断(ログに異常がないか)を行うことで、二次障害を防ぎながら安全に自動復旧します。
全体構成図
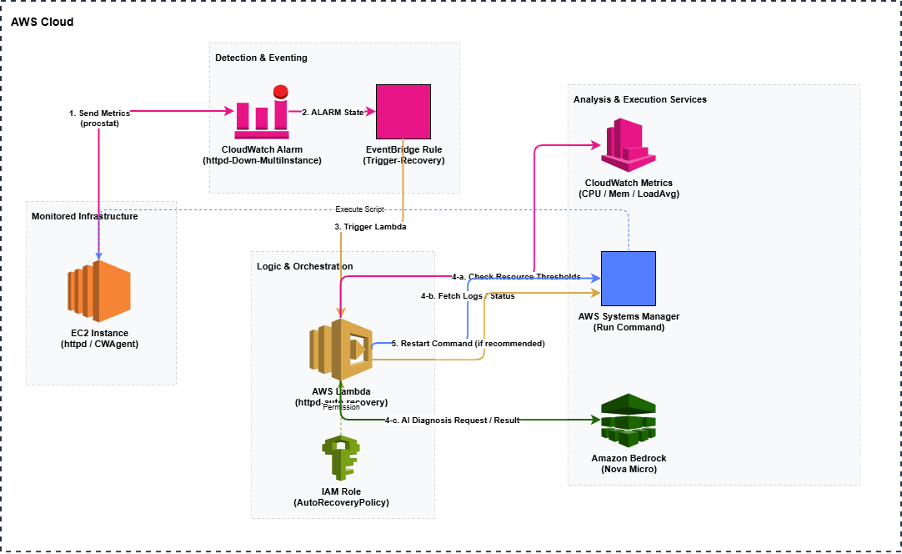
[ ユーザー / クライアント ]
         │
         ▼ (HTTPS)
[ AWS ALB / EC2 (httpd) ] (Web サーバー / サービス提供)
   │               ▲
   │ (1) 監視      │ (5) 自動復旧 (SSM Run Command)
   ▼               │
[ CloudWatch Alarm ] ──(2) アラーム発報──► [ EventBridge ]
   │                                            │
   ├──(電話 / Slack 連携オプション)              (3) 起動
   ▼                                            │
 [ 管理者通知 ]                                 ▼
                                    [ AWS Lambda ]
                                       ├── (4-a) 負荷チェック (CloudWatch Metrics)
                                       ├── (4-b) ログ解析 (Amazon Bedrock)
                                       └── (5)   再起動指示 (SSM Systems Manager)
自動リカバリシステムの詳細処理フロー
障害検知から復旧まで、以下のステップに沿って処理が行われます。
①プロセス監視とアラーム検知(EC2→CloudWatch→EventBridge)
- EC2上のCloudWatch Agentがprocstat_lookup_pid_countを収集し、httpdのプロセス数を監視します。
- httpdプロセス数が0(停止)になると、CloudWatch Alarm(HttpdDownAlarm)がALARM状態へ遷移します。
- ALARM状態への遷移をトリガーとして、EventBridgeルールが自動リカバリ用Lambda関数(httpd-auto-recovery-multi)を起動します。
②負荷保護のための安全診断(Lambda→CloudWatch Metrics)
Lambda関数はリカバリ処理を開始する前に、対象インスタンスのリソース状態をCloudWatchから取得・検証します。
- メモリ使用率(mem_used_percent):80.0%超
- CPU使用率(cpu_usage_active):80.0%超
- ロードアベレージ(load1):5.0超
【安全制御ロジック】上記3つのうちいずれか1つでも閾値を超えている場合、過負荷やリソース枯渇によるプロセス停止と判断します。この状態で再起動を行うと無限ループやさらなる負荷増大を引き起こすおそれがあるため、自動再起動をスキップ(SKIPPED)して管理者にアラートを通知します。
③ログ取得とAI診断(Lambda→SSM→Bedrock)
リソース状態が安全基準を満たしている場合、以下のロジックでAI診断へ進みます。
- ログ取得:SSM Run Command経由で、EC2上の/var/log/httpd/error_logの直近のログおよびsystemctl status httpdの出力を取得します。
- Bedrock解析:取得したログをAmazon Bedrock(Nova Microなど)に送信し、プロセスの再起動で復旧可能かどうかを解析させます。
- 判定:Bedrockからshould_restart: trueのJSONレスポンスを受け取った場合のみ、次の復旧アクションへ遷移します。
④自動再起動の実行(Lambda→SSM→EC2)
AIの推奨結果に基づき、LambdaはSSM Run Commandを使用して対象のEC2インスタンス上でコマンドを実行します。
Bash
sudo systemctl restart httpd再起動が完了すると、CloudWatch Alarmが正常状態(OK)へ復帰し、一連の自動復旧フローが完了します。
構築に必要なAWS IAM権限(IAMロール・ポリシー)
このシステムを正常かつ安全に動作させるために、各コンポーネントに適切な権限を付与する必要があります。最小権限原則(Least Privilege)に基づいて設定します。
EC2インスタンス用IAMロール(Instance Profile)
EC2がCloudWatch Agentを動かし、SSMからの制御を受けるために付与します。
- マネージドポリシー:
- AmazonSSMManagedInstanceCore(SSMからのコマンド実行やログ取得に必要)
- CloudWatchAgentServerPolicy(プロセス数やメモリなどのメトリクス送信に必要)
リカバリ用Lambda関数のIAMロール
LambdaがCloudWatchのメトリクスを取得し、SSM経由でEC2を操作してBedrockでAI診断を行うための権限です。Bedrock呼び出し権限には、通常の基盤モデル(foundation-model)に加えて、リージョン推論プロファイル(inference-profile(例:apac.amazon.nova-micro-v1:0))のリソース指定も含めて厳格化しています。
- 基本権限(CloudWatch Logs発行):
- AWSLambdaBasicExecutionRole(マネージドポリシー)
- インラインポリシー定義例:
JSON
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sidebar": "CloudWatch メトリクス取得権限",
      "Effect": "Allow",
      "Action": [
        "cloudwatch:GetMetricStatistics",
        "cloudwatch:GetMetricData"
      ],
      "Resource": "*"
    },
    {
      "Sidebar": "SSM Run Command によるコマンド実行・結果取得",
      "Effect": "Allow",
      "Action": [
        "ssm:SendCommand",
        "ssm:GetCommandInvocation"
      ],
      "Resource": [
        "arn:aws:ssm:*:*:document/AWS-RunShellScript",
        "arn:aws:ec2:*:*:instance/*"
      ]
    },
    {
      "Sidebar": "Amazon Bedrock モデル呼び出し権限(基盤モデルおよび推論プロファイル)",
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModel"
      ],
      "Resource": [
        "arn:aws:bedrock:*:*:foundation-model/*",
        "arn:aws:bedrock:*:*:inference-profile/*"
      ]
    }
  ]
}
EventBridgeルールの権限
EventBridgeがCloudWatch Alarm発生時にLambda関数を呼び出すためのリソースベースポリシー(Lambda側のアクセス許可)です。
- Lambda側リソースポリシー設定:lambda:InvokeFunctionの実行権限を、対象の EventBridgeルールARNからの呼び出しに対して許可します。
CloudFormationサンプルテンプレートとデプロイ手順
本構成(IAMロール、Lambda 関数、CloudWatch Alarm、EventBridge ルール、パーミッション設定)のスタックを一括で構築できるCloudFormationテンプレートのサンプルです。
テンプレートの特徴・ポイント
- マルチインスタンス対応:パラメータTargetInstanceIdsでカンマ区切りのインスタンスIDリストを受け取り、Lambda側でループ処理を行います。
- 安全制御ロジックの内蔵:Pythonコード内でcheck_metric_threshold関数を実装し、1分・3分・5分の各平均値でCPU/メモリ80%、ロードアベレージ 5.0を超えているか診断します。
- Amazon Bedrock (Nova Micro)連携:軽量・高速なapac.amazon.nova-micro-v1:0をデフォルトモデルとして指定し、厳格なJSON出力フォーマットを要求して判定精度を高めています。IAMロール定義でもfoundation-modelとinference-profileの双方を最小限の範囲で許可しています。
テンプレートコード(template.yaml)
YAML
AWSTemplateFormatVersion: '2010-09-09'
Description: Fast-detection auto-recovery for EC2 instances using CloudWatch Alarm, Bedrock Nova Micro, and SSM.

Parameters:
  TargetInstanceIds:
    Type: CommaDelimitedList
    Default: "XXX"
    Description: Comma-separated EC2 Instance IDs to monitor (e.g. XXX or i-xxxxxx).
  ModelId:
    Type: String
    Default: apac.amazon.nova-micro-v1:0
    Description: Bedrock Model ID to use for diagnosis.
  EvaluationPeriodSeconds:
    Type: Number
    Default: 60
    AllowedValues: [10, 30, 60]
    Description: Evaluation period in seconds for the CloudWatch Alarm (10, 30, or 60).

Resources:
  LambdaRole:
    Type: AWS::IAM::Role
    Properties:
      AssumeRolePolicyDocument:
        Version: '2012-10-17'
        Statement:
          - Effect: Allow
            Principal:
              Service: lambda.amazonaws.com
            Action: sts:AssumeRole
      ManagedPolicyArns:
        - arn:aws:iam::aws:policy/AmazonSSMFullAccess
      Policies:
        - PolicyName: AutoRecoveryPolicy
          PolicyDocument:
            Version: '2012-10-17'
            Statement:
              - Effect: Allow
                Action:
                  - logs:CreateLogGroup
                  - logs:CreateLogStream
                  - logs:PutLogEvents
                  - cloudwatch:GetMetricStatistics
                Resource: "*"
              - Effect: Allow
                Action: ec2:DescribeInstances
                Resource: "*"
              - Effect: Allow
                Action: bedrock:InvokeModel
                Resource:
                  - "arn:aws:bedrock:*:*:foundation-model/*"
                  - "arn:aws:bedrock:*:*:inference-profile/*"

  LambdaLogGroup:
    Type: AWS::Logs::LogGroup
    Properties:
      LogGroupName: /aws/lambda/httpd-auto-recovery-multi
      RetentionInDays: 7

  RecoveryFunction:
    Type: AWS::Lambda::Function
    DependsOn: LambdaLogGroup
    Properties:
      FunctionName: httpd-auto-recovery-multi
      Runtime: python3.12
      Handler: index.lambda_handler
      Role: !GetAtt LambdaRole.Arn
      Timeout: 120
      Environment:
        Variables:
          INSTANCE_IDS: !Join [",", !Ref TargetInstanceIds]
          MODEL_ID: !Ref ModelId
      Code:
        ZipFile: |
          import json
          import os
          import time
          import boto3
          from datetime import datetime, timedelta

          ec2 = boto3.client('ec2')
          cloudwatch = boto3.client('cloudwatch')
          ssm = boto3.client('ssm')
          bedrock = boto3.client('bedrock-runtime')

          MODEL_ID = os.environ.get('MODEL_ID', 'apac.amazon.nova-micro-v1:0')

          def get_instance_state(instance_id):
              try:
                  res = ec2.describe_instances(InstanceIds=[instance_id])
                  state = res['Reservations'][0]['Instances'][0]['State']['Name']
                  return state
              except Exception as e:
                  print(f"[{instance_id}] Error describing instance state: {e}")
                  return "unknown"

          def check_metric_threshold(instance_id, namespace, metric_name, threshold, comparison='gt'):
              now = datetime.utcnow()
              periods = [1, 3, 5]
              dimensions = [{'Name': 'InstanceId', 'Value': instance_id}]

              for minutes in periods:
                  response = cloudwatch.get_metric_statistics(
                      Namespace=namespace,
                      MetricName=metric_name,
                      Dimensions=dimensions,
                      StartTime=now - timedelta(minutes=minutes),
                      EndTime=now,
                      Period=minutes * 60,
                      Statistics=['Average']
                  )
                  datapoints = response.get('Datapoints', [])
                  if datapoints:
                      avg_val = datapoints[0]['Average']
                      print(f"[{instance_id}] [{metric_name}] Average for last {minutes} min: {avg_val:.2f}")
                      if comparison == 'gt' and avg_val > threshold:
                          print(f"[{instance_id}] Safety Check NG: {metric_name} last {minutes} min average ({avg_val:.2f}) exceeds threshold ({threshold})")
                          return False
                  else:
                      print(f"[{instance_id}] [{metric_name}] No datapoints for last {minutes} min")
              return True

          def run_ssm_command(instance_id, commands):
              res = ssm.send_command(
                  InstanceIds=[instance_id],
                  DocumentName="AWS-RunShellScript",
                  Parameters={'commands': commands}
              )
              cmd_id = res['Command']['CommandId']
              time.sleep(3)
              inv_res = ssm.get_command_invocation(CommandId=cmd_id, InstanceId=instance_id)
              return inv_res.get('StandardOutputContent', '')

          def process_instance(instance_id):
              print(f"--- Processing Instance: {instance_id} ---")

              instance_state = get_instance_state(instance_id)
              print(f"[{instance_id}] Current Instance State: {instance_state}")

              if instance_state != 'running':
                  reason = f"Skipped auto-recovery because the instance status is '{instance_state}' (not running)."
                  print(f"[{instance_id}] {reason}")
                  return {"instance_id": instance_id, "status": "SKIPPED", "reason": reason}

              is_memory_safe = check_metric_threshold(instance_id, 'CWAgent', 'mem_used_percent', threshold=80.0)
              is_cpu_safe = check_metric_threshold(instance_id, 'CWAgent', 'cpu_usage_active', threshold=80.0)
              is_load_safe = check_metric_threshold(instance_id, 'CWAgent', 'load1', threshold=5.0)

              if not is_memory_safe or not is_cpu_safe or not is_load_safe:
                  reason = "Skipped auto-recovery because Memory/CPU exceeded 80% or Load Average exceeded 5.0."
                  print(f"[{instance_id}] {reason}")
                  return {"instance_id": instance_id, "status": "SKIPPED", "reason": reason}

              print(f"[{instance_id}] Resource check passed. Fetching logs and starting Bedrock diagnosis.")
              raw_output = run_ssm_command(instance_id, [
                  "echo '=== SYSTEMD STATUS ==='",
                  "systemctl status httpd",
                  "echo '=== HTTPD ERROR LOG ==='",
                  "tail -n 30 /var/log/httpd/error_log 2>/dev/null || echo 'No error log found'"
              ])

              prompt = f"""
              The following is the status and error log of a web server (httpd).
              Analyze the status and determine if the httpd process should be restarted.

              [Target Instance]
              {instance_id}

              [Fetched Log Data]
              {raw_output}

              [Rules for Judgment]
              1. If httpd status is 'inactive (dead)', 'failed', or NOT running, you MUST set "should_restart" to true so it can be recovered.
              2. ONLY set "should_restart" to false if httpd is currently 'active (running)'.

              [Output Format]
              Return ONLY valid JSON with no markdown and no explanation outside JSON:
              {{
                "should_restart": true or false,
                "reason": "Specific reason for the decision in 1 sentence."
              }}
              """

              body = json.dumps({
                  "messages": [
                      {
                          "role": "user",
                          "content": [{"text": prompt}]
                      }
                  ],
                  "inferenceConfig": {
                      "maxTokens": 300
                  }
              })

              response = bedrock.invoke_model(
                  modelId=MODEL_ID,
                  contentType="application/json",
                  accept="application/json",
                  body=body
              )

              res_payload = json.loads(response['body'].read())
              ai_output_str = res_payload['output']['message']['content'][0]['text'].strip()

              try:
                  result = json.loads(ai_output_str)
              except Exception:
                  result = {"should_restart": False, "reason": "Failed to parse AI output."}

              print(f"[{instance_id}] [AI Diagnosis Result] {json.dumps(result)}")

              if result.get("should_restart") is True:
                  print(f"[{instance_id}] Restarting httpd based on safe resource level and AI diagnosis.")
                  run_ssm_command(instance_id, ["sudo systemctl restart httpd"])
                  return {"instance_id": instance_id, "status": "RESTARTED", "reason": result.get("reason")}
              else:
                  print(f"[{instance_id}] Skipping restart based on AI decision.")
                  return {"instance_id": instance_id, "status": "SKIPPED", "reason": result.get("reason")}

          def lambda_handler(event, context):
              target_instances = []

              try:
                  dimensions = event['detail']['configuration']['metrics'][0]['metricStat']['metric']['dimensions']
                  for dim in dimensions:
                      if dim['name'] == 'InstanceId':
                          target_instances.append(dim['value'])
              except Exception:
                  pass

              if not target_instances:
                  raw_ids = os.environ.get('INSTANCE_IDS', '')
                  target_instances = [i.strip() for i in raw_ids.split(',') if i.strip()]

              print(f"Target Instances to process: {target_instances}")

              results = []
              for instance_id in target_instances:
                  res = process_instance(instance_id)
                  results.append(res)

              return {"results": results}

  HttpdDownAlarm:
    Type: AWS::CloudWatch::Alarm
    Properties:
      AlarmName: "httpd-Down-MultiInstance"
      MetricName: "procstat_lookup_pid_count"
      Namespace: "CWAgent"
      Statistic: "Average"
      Period: !Ref EvaluationPeriodSeconds
      EvaluationPeriods: 1
      DatapointsToAlarm: 1
      Threshold: 1.0
      ComparisonOperator: "LessThanThreshold"
      TreatMissingData: "breaching"
      Dimensions:
        - Name: "InstanceId"
          Value: !Select [0, !Ref TargetInstanceIds]
        - Name: "pattern"
          Value: "httpd"
        - Name: "pid_finder"
          Value: "native"
      AlarmActions:
        - !GetAtt RecoveryFunction.Arn

  AlarmRule:
    Type: AWS::Events::Rule
    Properties:
      Name: "Trigger-Recovery-MultiInstance"
      EventPattern:
        source:
          - "aws.cloudwatch"
        detail-type:
          - "CloudWatch Alarm State Change"
        detail:
          state:
            value:
              - "ALARM"
          alarmName:
            - "httpd-Down-MultiInstance"
      Targets:
        - Id: TargetLambda
          Arn: !GetAtt RecoveryFunction.Arn

  LambdaPermissionForEvents:
    Type: AWS::Lambda::Permission
    Properties:
      FunctionName: !Ref RecoveryFunction
      Action: lambda:InvokeFunction
      Principal: events.amazonaws.com
      SourceArn: !GetAtt AlarmRule.Arn

  LambdaPermissionForAlarm:
    Type: AWS::Lambda::Permission
    Properties:
      FunctionName: !Ref RecoveryFunction
      Action: lambda:InvokeFunction
      Principal: cloudwatch.amazonaws.com
      SourceArn: !GetAtt HttpdDownAlarm.Arn
デプロイコマンド例(PowerShell/Windows環境)
作成したtemplate.yamlを使用して、AWS CLI(PowerShell)からスタックをデプロイするコマンド例です。パラメータTargetInstanceIdsに対象のEC2インスタンスID(例:XXX)を指定して実行します。
PowerShell
aws cloudformation deploy `
  --template-file ./template.yaml `
  --stack-name ai-lambda `
  --parameter-overrides TargetInstanceIds="XXX" ModelId="apac.amazon.nova-micro-v1:0" `
--capabilities CAPABILITY_IAM CAPABILITY_NAMED_IAM- –template-file:作成したCloudFormationテンプレートファイルのパス(./template.yaml)を指定します。
- –parameter-overrides:監視対象のEC2インスタンス ID(TargetInstanceIds=”XXX”)および利用するBedrockモデルID(ModelId=”apac.amazon.nova-micro-v1:0″)を上書き指定します。複数指定する場合は”XXX,YYY”のようにカンマ区切りで指定します。
- –capabilities:IAMロールを自動生成するため、CAPABILITY_IAMおよびCAPABILITY_NAMED_IAMの付与が必要です。
参考:Amazon Bedrockの主要なModel ID一覧と選定理由
本システムで利用できる主なBedrockモデルの選択肢です。
| モデル名 | Model ID | 特徴・推奨されるユースケース |
| Amazon Nova Micro | apac.amazon.nova-micro-v1:0 | テキスト専用・高速・低コスト。ログの一次診断や判定処理に適している。(※本構成で採用) |
| Amazon Nova Lite | apac.amazon.nova-lite-v1:0 | 軽量かつマルチモーダル対応。コストを抑えつつやや複雑な推論を行いたい場合に適している。 |
| Amazon Nova Pro | apac.amazon.nova-pro-v1:0 | 高精度な分析と複雑な文脈理解が可能。大規模なログ分析や詳細な原因特定に適している。 |
| Anthropic Claude 3.5 Haiku | apac.anthropic.claude-3-5-haiku-20241022-v1:0 | 軽量・高速で、高品質な出力が期待できる。複雑なエラーログの読み取り精度を重視する場合に適している。 |
| Anthropic Claude 3.5 Sonnet | apac.anthropic.claude-3-5-sonnet-20241022-v2:0 | 高い推論能力。システム全体の相関分析など高度なタスクに適している。 |
【apac.amazon.nova-micro-v1:0(Nova Micro)の選定結果・効果】
- 応答時間の短さ(低レイテンシ):AI のレスポンス待ち時間を1〜2秒以内に抑え、リカバリ処理全体の遅延を抑えられます。
- コストの低さ:1,000入力トークンあたり$0.000035程度と非常に安価なため、定期的な監視や大量アラートが発生してもコストの負担を抑えられます。
- JSON出力の安定性:構造化出力の指示に従いやすく、Lambda側のコードで安全に判定処理が行えます。
自動リカバリ構成のメリット
- ダウンタイムの短縮:深夜や休日であっても、障害発生から数分以内に自動でWebサーバーが復旧します。
- 二次障害の防止:単純な自動再起動ではなく、CPU/メモリ/ロードアベレージの閾値チェックを行うことで、スパイク時や過負荷時の不要な再起動の連鎖を防ぎます。
- AIによる高度な判断:Amazon Bedrockがログを解析して原因を一次診断するため、ログ解析の手間を減らし、安全性の高い復旧自動化を実現できます。
補足:動作検証・運用確認に便利なAWS CLIコマンド
本システムの導入時や障害テスト時には、マネジメントコンソールを開かずにAWS CLIから状態を迅速に確認できます。以下のコマンドを活用すると効率的です。
プロセス監視メトリクスの推移確認
直近10分間のhttpdプロセス数の推移を、タイムスタンプ順の表形式で出力します。
Bash
aws cloudwatch get-metric-statistics \
   --namespace "CWAgent" \
   --metric-name "procstat_lookup_pid_count" \
   --dimensions Name=InstanceId,Value=$INSTANCE_ID Name=exe,Value=httpd Name=pid_finder,Value=native \
   --start-time $(date -u -d '10 minutes ago' +%Y-%m-%dT%H:%M:%SZ) \
   --end-time $(date -u +%Y-%m-%dT%H:%M:%SZ) \
   --period 60 \
   --statistics Average \
   --query "sort_by(Datapoints, &Timestamp)[*].[Timestamp, Average]" \
   --output table
アラーム状態と変更理由の確認
対象アラーム(httpd-Down-MultiInstance)の現在の状態(OK/ALARM)、最終更新日時、発報理由を迅速に確認します。
Bash
aws cloudwatch describe-alarms \
   --alarm-names "httpd-Down-MultiInstance" \
   --query "MetricAlarms[*].[AlarmName, StateValue, StateUpdatedTimestamp, StateReason]" \
   --output table
まとめ
本記事で紹介した自動復旧構成に加え、ベアサポートでは要件に合わせた各種アラート通知や外部ツール連携の構築も可能です。
- 電話自動通報機能(Amazon Connect 連携):夜間や休日などの重大障害発生時、担当者の携帯電話へ自動音声で緊急コールを発信。
- ビジネスチャット即時通知(Slack / Microsoft Teams連携):障害発生時のスタック情報、自動復旧の成否、AIによるログ診断結果をSlackやTeamsの特定チャンネルへ即座にカード形式で通知。
- チケット起票自動化(Jira/Backlog連携):自動リカバリがスキップされた高負荷障害時など、手動対応が必要なケースで自動的に運用チケットを発行。
適切なIAM権限を設定し、AWSの標準運用ツール(CloudWatch、SSM、Lambda、Bedrock)とこれらの通知基盤を組み合わせることで、手動介入を最小限に抑えた自律的かつ透明性の高いWebサーバー運用を実現できます。システム構築やカスタマイズのご相談は、ぜひベアサポートまでお気軽にお問い合わせください。
